インデックスの仕組みを図解で説明 〜B木で検索が速くなる理由と、遅くなる場合〜
データベースにインデックスを作ると、なぜ検索が速くなるのか説明できますか?
「検索が遅いならインデックスを張ればいい」と聞いたことがある人も多いと思います。
ですが、インデックスはどんな時でも速くなる魔法ではありません。
インデックスの仕組みと、速くなる場合・遅くなる場合について、図を使って説明していきます。
インデックスとは?
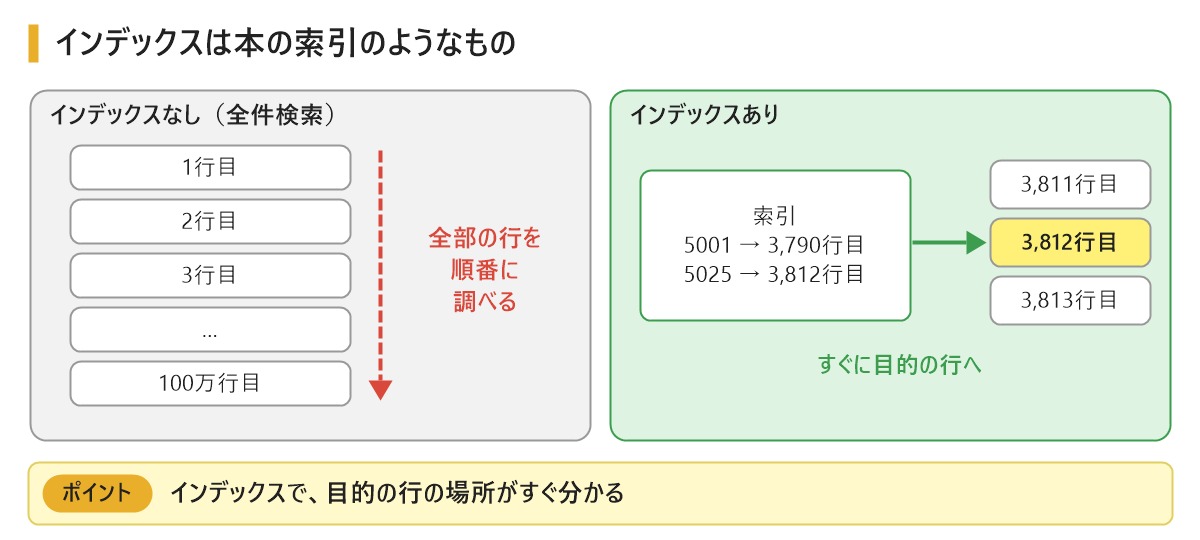
インデックスは、データを速く探すために、データベースが別に持っている目次のようなもの です。
本の巻末にある索引をイメージしてください。
索引がない本で「DNS」という言葉を探すには、1ページ目から順番に読んでいくしかありません。
索引があれば、「DNS → 52ページ」と調べて、すぐにそのページを開けます。
データベースも同じです。
インデックスがない列で検索すると、表の1行目から最後の行まで、全部の行を調べます。
これを 全件検索(フルスキャン) といいます。
インデックスがあれば、目的の行がどこにあるかをすぐに見つけられます。
B木の仕組み
多くのデータベースでは、インデックスに B木(ビーき) という形を使います。
B木は、データを木の枝のように階層にして並べたものです。
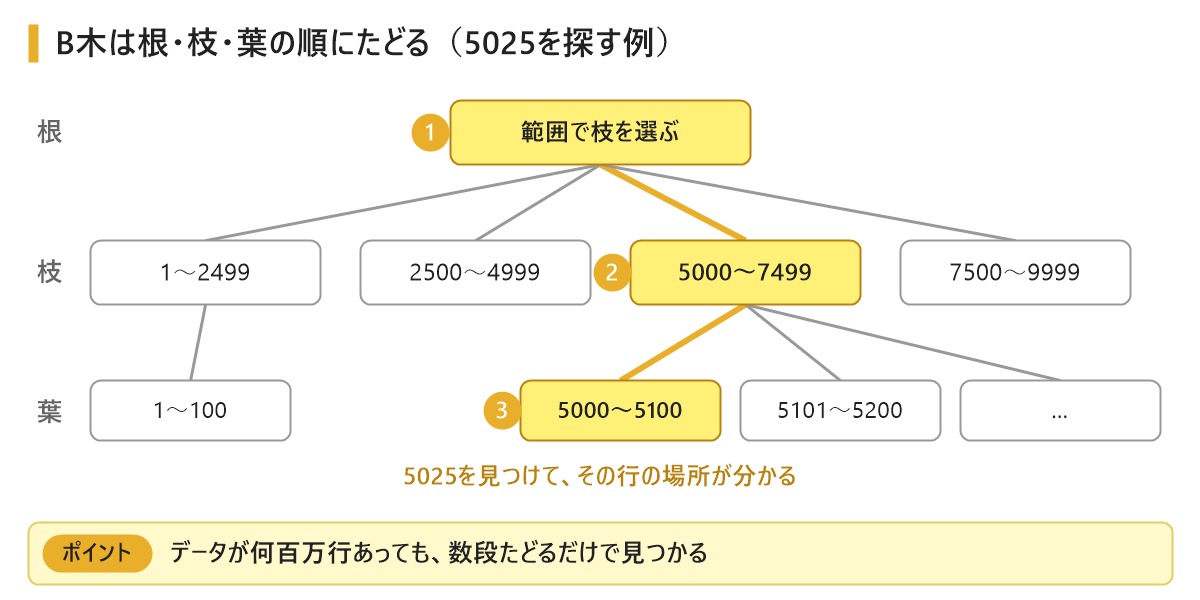
一番上を「根」、途中を「枝」、一番下を「葉」といいます。
例えば、社員番号が「5025」の行を探す場合は、次のようにたどります。
① 根で「5025は、5000〜7499の枝へ」と確認する
② 枝で「5025は、5000〜5100の葉へ」と確認する
③ 葉で「5025」を見つけ、その行の場所を知る
1つの枝から、たくさんの枝に分かれているのがB木の特徴です。
そのため、データが何百万行あっても、根から葉まで数段たどるだけで目的の行に着けます。
ちなみに、B木の「B」は二分木(Binary tree)の「B」ではありません。
二分木は1つの枝から2つにしか分かれませんが、B木はもっと多くに分かれます。
B+木と範囲の検索
実際のデータベースでよく使われているのは、B木を改良した B+木(ビープラスぎ) です。
B+木では、葉にすべての値が順番に並び、隣の葉とつながっています。
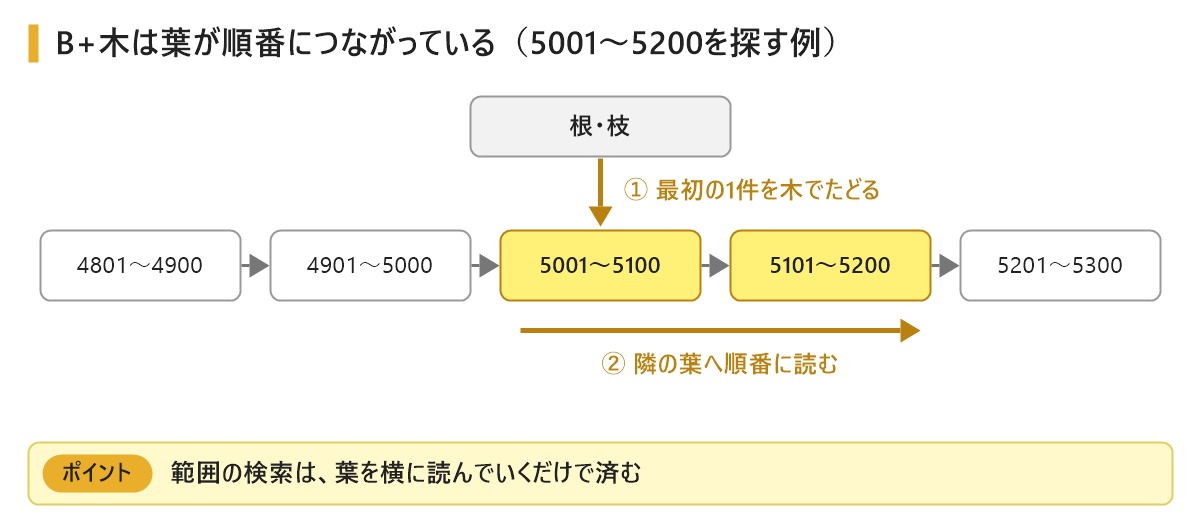
そのため、「社員番号が5001〜5200の社員」のような範囲の検索も得意です。
最初の1件を木でたどって見つけたら、あとは葉を横に順番に読んでいくだけで済みます。
インデックスで遅くなる場合
インデックスは検索を速くしますが、良いことばかりではありません。
データを追加・更新・削除するたびに、インデックスも書き換える必要がある からです。
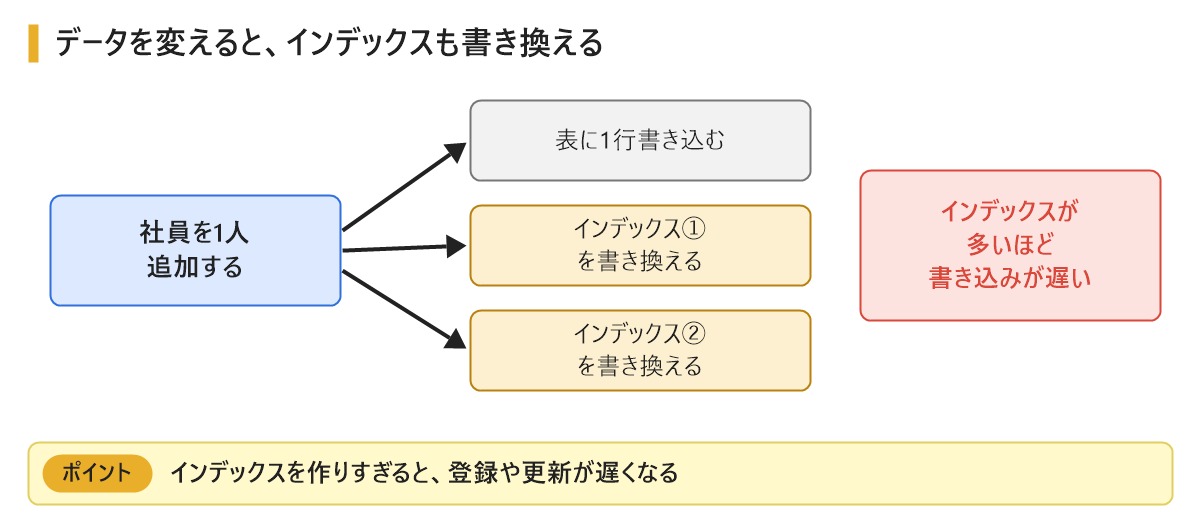
本でいえば、本文に1ページ追加するたびに、索引も直さなければならないのと同じです。
インデックスをたくさん作るほど、書き換える量が増えて、データの登録や更新が遅くなります。
また、インデックスのデータを保存するための容量も必要です。
インデックスが向いている列・向いていない列
インデックスは、どの列に作っても効果があるわけではありません。
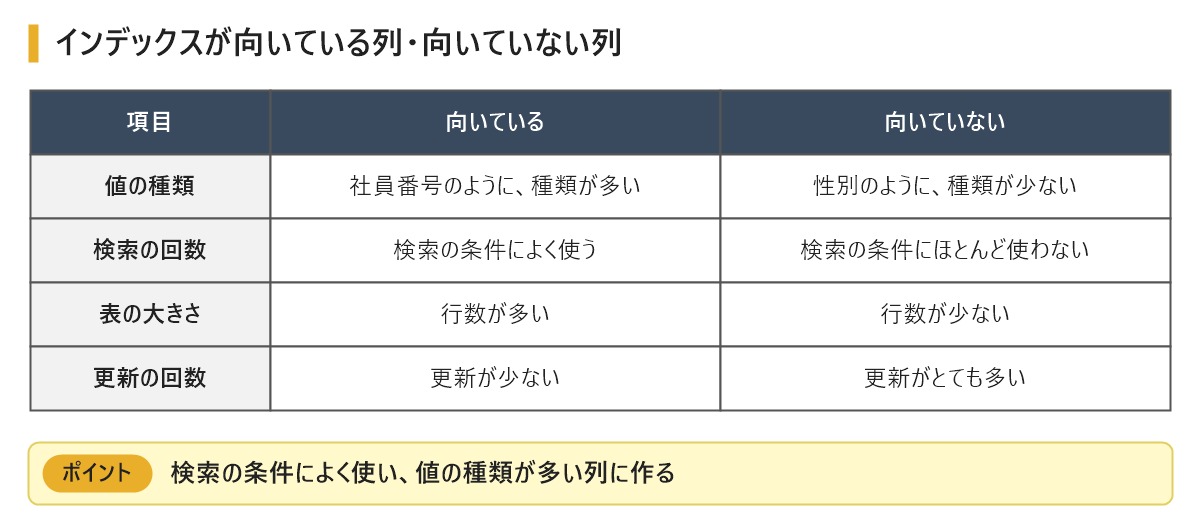
値の種類が少ない列は、インデックスで絞り込んでも多くの行が残るので、効果が小さくなります。
行数が少ない表は、全件検索でもすぐに終わるので、インデックスがなくても困りません。
まとめ
今回はインデックスの仕組みについて説明しました。
インデックスは、データを速く探すための目次のようなもので、多くのデータベースではB木やB+木の形で持っています。
検索は速くなりますが、データの追加・更新・削除の時にはインデックスも書き換えるので、作りすぎると遅くなります。
「検索の条件によく使い、値の種類が多い列に作る」と覚えておきましょう。
データベースの基本については、データベースの種類を図解で解説の記事で説明しています。
表の設計の考え方については、正規化を図解で説明の記事で説明しています。
表をつなげて取り出すJOINについては、SQLのJOINの仕組みを図解で説明の記事で説明しています。