レプリケーションとシャーディングの違いを図解で説明 〜データベースを複数のサーバに分ける方法〜
データベースの「レプリケーション」と「シャーディング」の違いを説明できますか?
どちらもデータベースを複数のサーバで動かす方法ですが、目的と仕組みが違います。
利用者が増えて1台のサーバでは足りなくなった時に、どちらを使うのかが分かれます。
レプリケーションとシャーディングの仕組みと違いについて、図を使って説明していきます。
1台のデータベースの困りごと
データベースを1台のサーバで動かしていると、次のような困りごとが出てきます。
- サーバが壊れると、サービス全体が止まってしまう
- 読み込みの量が増えると、処理が追いつかなくなる
- データが増えると、1台のディスクや処理の能力では足りなくなる
これを解決するために、データベースを複数のサーバに分けます。
レプリケーション
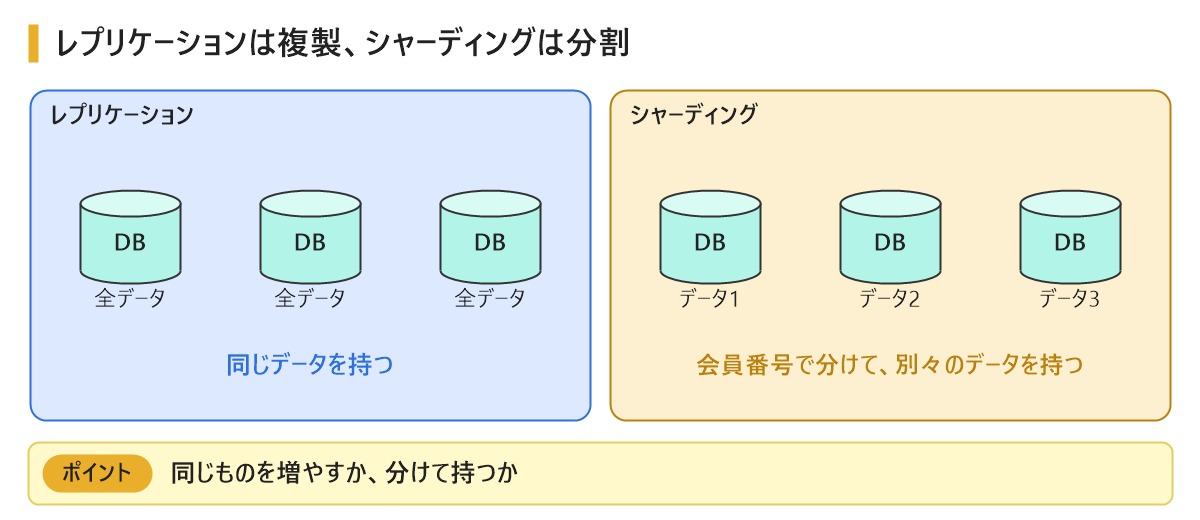
レプリケーションは、同じデータを、複数のサーバにコピーして持つ方法 です。
レプリケーションは英語で「複製」という意味です。
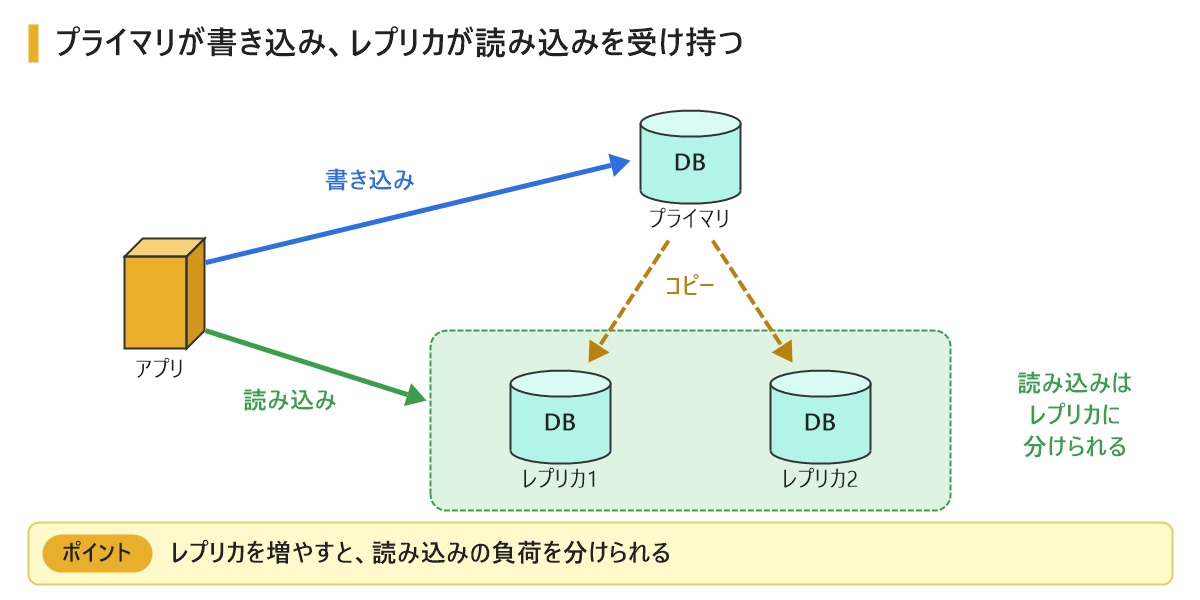
よく使われる構成では、サーバに次の役割を分けます。
- プライマリ: データの書き込みを受け付ける元のサーバ
- レプリカ: プライマリのデータをコピーして持つサーバ
プライマリで書き込まれたデータは、レプリカへ自動でコピーされます。
データの読み込みはレプリカに任せられるので、読み込みが多いサービスの負荷を分けられます。
また、プライマリが壊れても、レプリカをプライマリに切り替えればサービスを続けられます。
ただし、書き込みはプライマリ1台で受けるので、書き込みの負荷は分けられません。
同期と非同期
レプリカへのコピーのやり方には、同期と非同期があります。
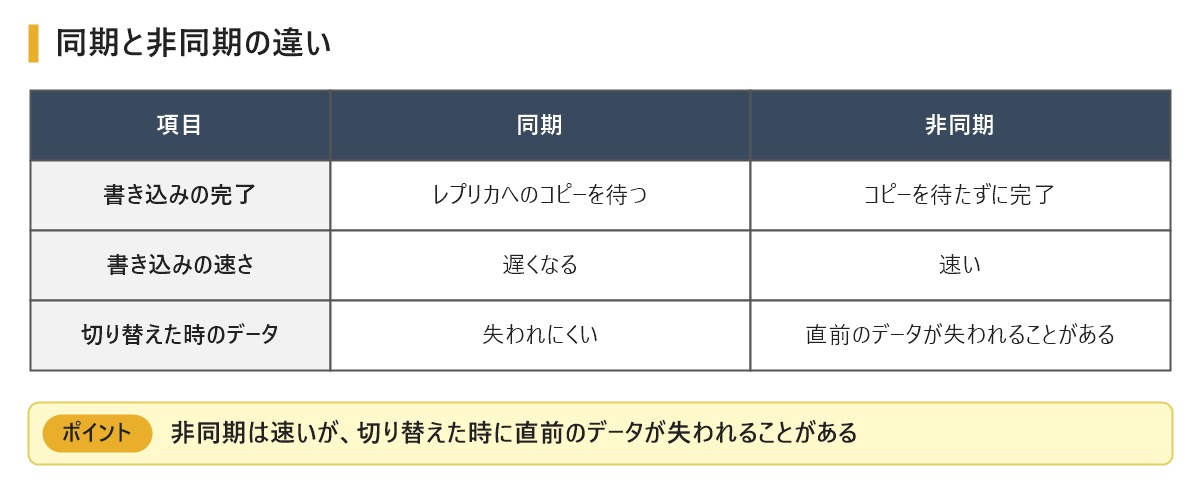
レプリカでは、プライマリに書き込んだデータが、少し遅れて読めるようになります。
そのため、書き込んだ直後にレプリカから読むと、古いデータが返ってくることがあります。
同期でも、多くの設定ではレプリカがデータを受け取るまでしか待たないので、この遅れは起こりえます。非同期では遅れがさらに大きくなりやすいので注意が必要です。
シャーディング
シャーディングは、データを分けて、別々のサーバに持たせる方法 です。
シャードは英語で「かけら」という意味です。
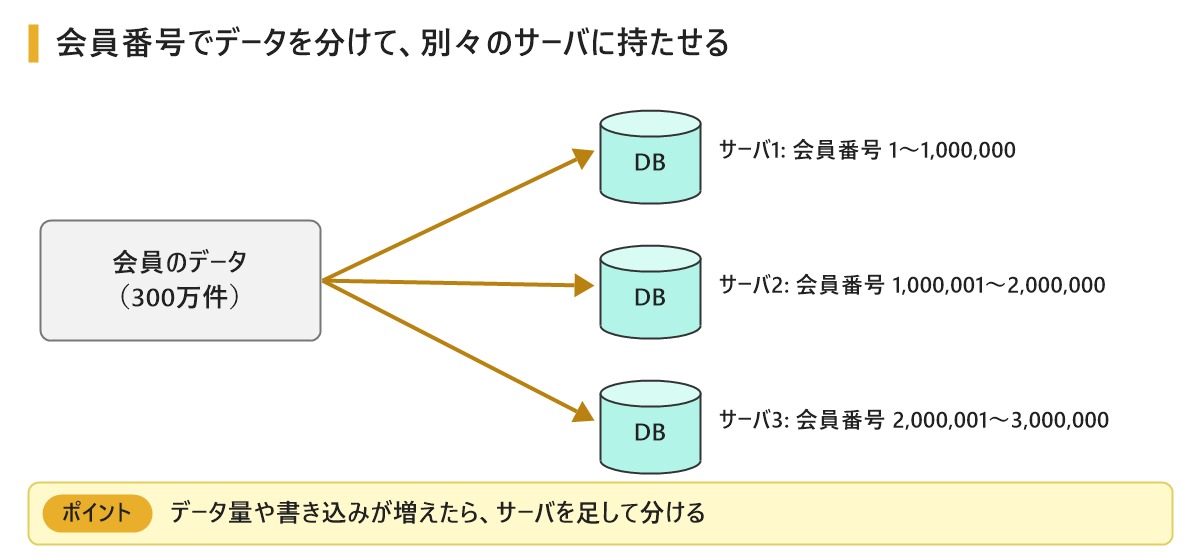
例えば、会員のデータを会員番号で分けて、次のように持たせます。
- サーバ1: 会員番号 1〜1,000,000
- サーバ2: 会員番号 1,000,001〜2,000,000
- サーバ3: 会員番号 2,000,001〜3,000,000
それぞれのサーバは、全体の一部のデータだけを持ちます。
書き込みも各サーバに分かれるので、データの量や書き込みが増えても、サーバを足して対応できます。
ただし、複数のサーバにまたがる検索や集計は難しくなります。
また、どのデータをどのサーバに置くかの決め方を、最初によく考える必要があります。
レプリケーションとシャーディングの違い
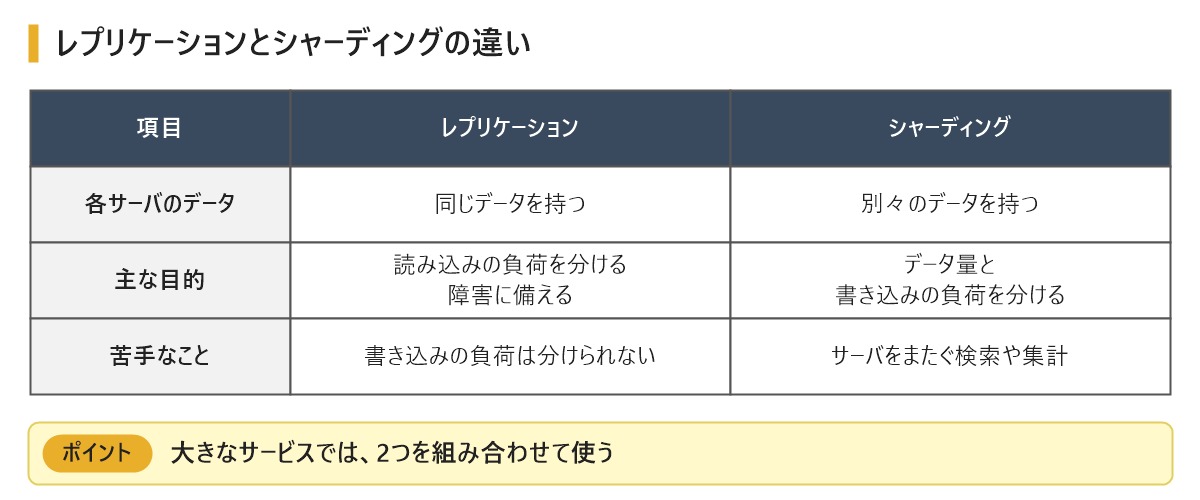
実際の大きなサービスでは、2つを組み合わせて使います。
データをシャーディングで分けたうえで、それぞれのサーバをレプリケーションで複製しておく形です。
なお、1台のデータベースの中で表を分けて持つ方法は、パーティショニングといいます。
まとめ
今回はレプリケーションとシャーディングの違いについて説明しました。
レプリケーションは同じデータを複数のサーバにコピーする方法で、読み込みの負荷を分け、障害に備えます。
シャーディングはデータを分けて別々のサーバに持たせる方法で、データ量と書き込みの負荷を分けます。
「同じものを増やすのがレプリケーション、分けて持つのがシャーディング」と覚えておきましょう。
ディスクを複数使って障害に備える方法については、RAIDの仕組みを図解で説明の記事で説明しています。
データベースのサーバを含めたシステムの構成については、2層・3層クライアントサーバシステムの違いを図解で説明の記事で説明しています。
1台のデータベースの中で検索を速くする方法については、インデックスの仕組みを図解で説明の記事で説明しています。